Ti è mai capitato di chiedere qualcosa a una chat di intelligenza artificiale e ricevere una risposta sicurissima, ben scritta… e completamente sbagliata? Un libro che non esiste, una citazione mai pronunciata, una legge con il numero sbagliato. Succede, e non è un guasto raro: è una conseguenza diretta di come funzionano questi sistemi. Capirlo, anche solo a grandi linee, cambia il modo in cui li usi.
Prima di tutto: l'AI non legge parole, legge token
I modelli linguistici che stanno dietro alle chat più diffuse non lavorano con le lettere e nemmeno con le parole intere. Il testo viene spezzato in token: pezzi che possono essere una parola corta, una parte di parola, un segno di punteggiatura o uno spazio con qualche lettera attaccata. Una parola comune può essere un token solo; una parola lunga o rara viene divisa in più pezzi.
Come ordine di grandezza, OpenAI indica che in un testo inglese un token corrisponde in media a circa quattro caratteri, cioè più o meno tre quarti di parola. In altre lingue, italiano compreso, il conto cambia, perché questi sistemi di suddivisione sono costruiti in buona parte su testi in inglese. È anche il motivo per cui i servizi a pagamento parlano di prezzi «per token» e di limiti di lunghezza misurati in token, non in pagine.
Da qui nasce una stranezza diventata famosa: chiedere a un modello quante volte compare una certa lettera in una parola può dare risultati sbagliati. Il modello non «vede» le singole lettere come le vediamo noi, vede pezzi di parola già raggruppati.
Il mestiere di un modello: indovinare il pezzo successivo
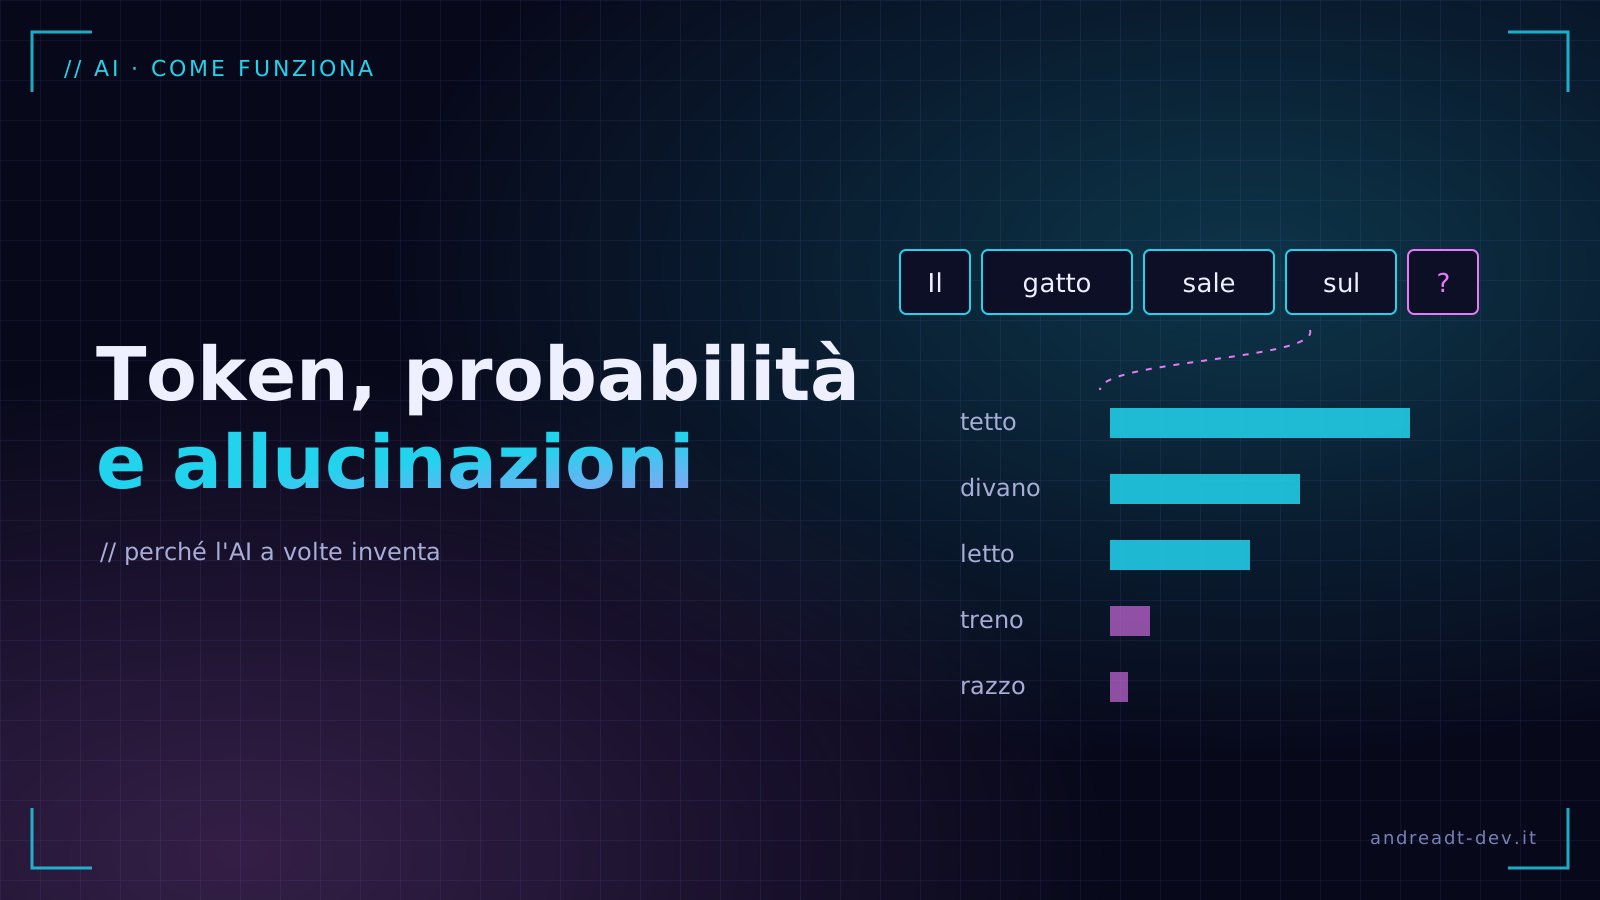
Semplificando parecchio, un modello linguistico fa una cosa sola: dato un testo, stima quali token è probabile che vengano dopo, ne sceglie uno, lo aggiunge e ripete. Token dopo token costruisce una risposta. Durante l'addestramento ha visto enormi quantità di testo e ha imparato quali sequenze sono plausibili.
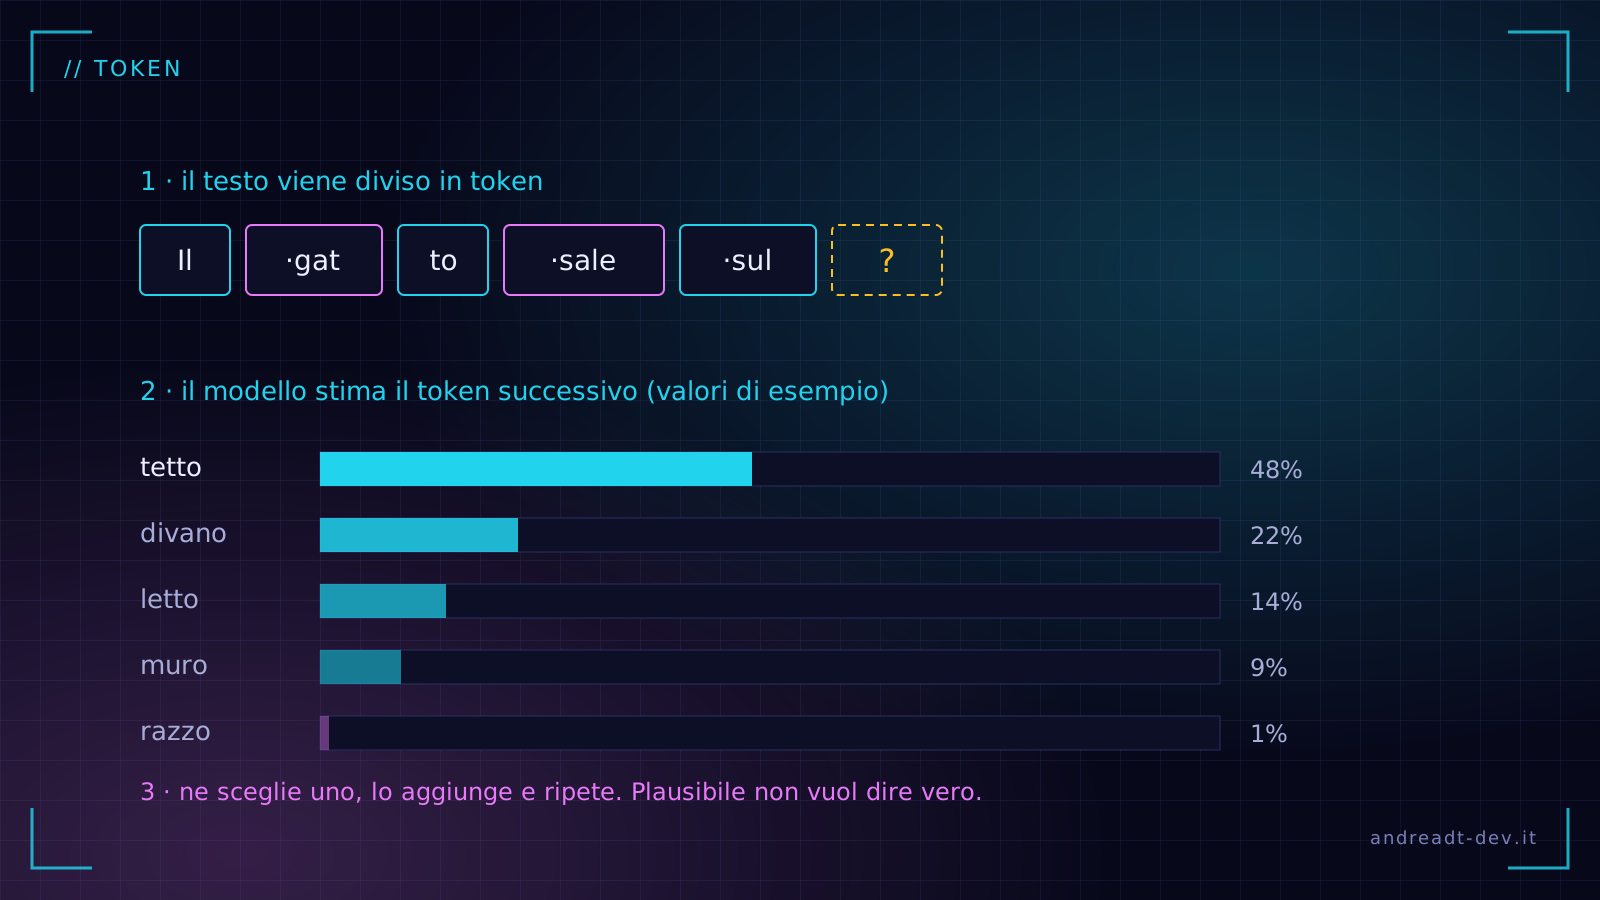
La parola chiave è plausibili. Il modello è bravissimo a produrre frasi che suonano come una risposta corretta. Ma «suonare corretta» ed «essere vera» non sono la stessa cosa. Quando l'informazione giusta compare spesso nei dati, le due cose tendono a coincidere. Quando l'informazione è rara, ambigua o semplicemente assente, il modello continua comunque a generare il testo più plausibile. E il testo più plausibile, a volte, è un'invenzione con tutti i dettagli al posto giusto.
Le allucinazioni hanno un nome
In gergo questi errori si chiamano allucinazioni. Il termine non è perfetto, perché fa pensare a qualcosa di eccezionale, mentre si tratta del normale meccanismo di generazione che prende la direzione sbagliata. Ci sono situazioni in cui succede più facilmente:
- domande su dettagli molto specifici: date precise, numeri, nomi poco noti, riferimenti bibliografici;
- fatti successivi alla data in cui il modello ha smesso di «studiare», se non ha accesso a una ricerca sul web;
- domande costruite su una premessa falsa, che il modello tende ad assecondare invece di contestare;
- richieste di citare a memoria fonti, link o sentenze.
Un caso vero: gli avvocati e le sentenze inventate
Nel 2023, in una causa davanti a un tribunale federale di New York contro la compagnia aerea Avianca, alcuni avvocati depositarono un atto che citava diverse sentenze precedenti. Il problema? Alcune di quelle sentenze non esistevano: erano state generate da ChatGPT, con nomi e citazioni credibili. Il giudice se ne accorse e gli avvocati furono sanzionati. È diventato un caso di scuola proprio perché mostra quanto un testo inventato possa sembrare professionale.
Come uso l'AI senza farmi ingannare
Non serve smettere di usare questi strumenti: io li uso ogni giorno. Serve usarli per ciò in cui sono forti. Ecco le regole che mi sono dato.
- Dagli il materiale, non chiedergli di ricordare. Se incolli un documento e chiedi di riassumerlo o di trovarci un'informazione, gli errori calano parecchio rispetto a una domanda «a memoria».
- Verifica tutto ciò che è un fatto. Date, cifre, nomi, citazioni e link vanno controllati su una fonte originale. Se la chat ti propone un link, aprilo davvero.
- Chiedi esplicitamente di dire «non lo so». Non elimina il problema, ma aiuta. Ancora meglio: chiedi di separare ciò di cui è sicuro da ciò che è una supposizione.
- Diffida delle premesse. Se la tua domanda contiene un errore, il modello potrebbe costruirci sopra. Riformulala in modo neutro.
- Usalo per scrivere, riorganizzare e spiegare. Bozze, riassunti, idee, riformulazioni di un testo che hai già: lì dà il meglio.
In sintesi
Un modello linguistico non è un'enciclopedia e nemmeno un bugiardo: è una macchina molto sofisticata che completa testi in modo plausibile. Quando plausibilità e verità coincidono, sembra magia. Quando non coincidono, sta a noi accorgercene. La buona notizia è che bastano poche abitudini per accorgersene quasi sempre.
Se ti incuriosisce da dove arriva tutto questo, ho raccontato le origini in curiosità sull'AI: da ELIZA al test di Turing.